
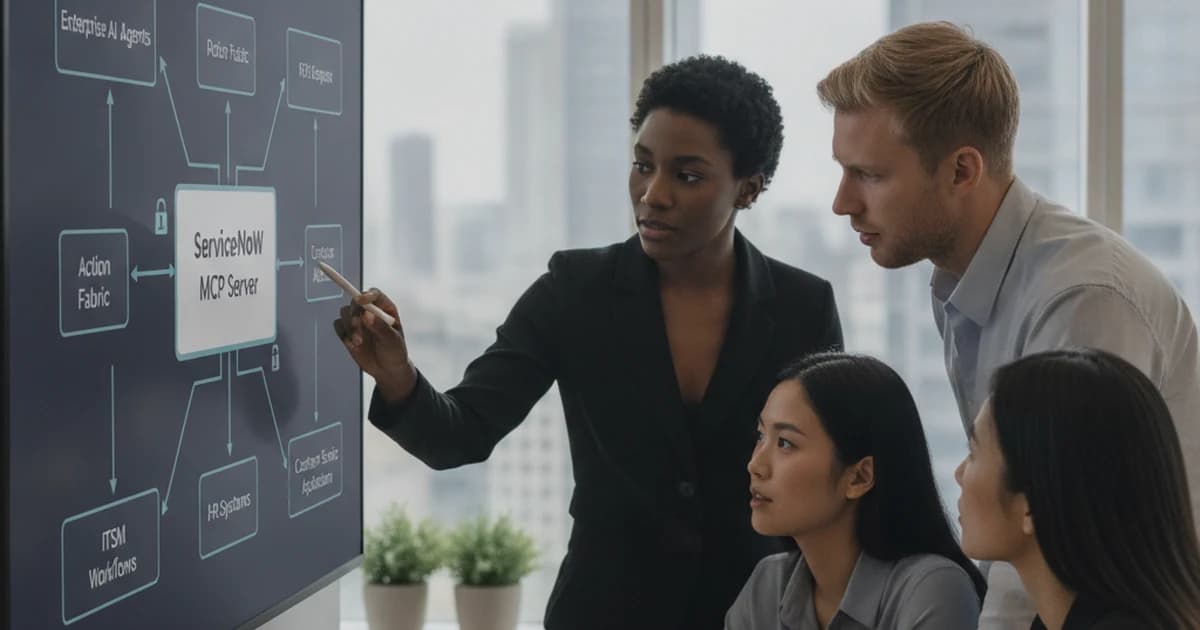
ServiceNow Australia-release: Action Fabric en MCP-server uitgelegd
Ontdek hoe de ServiceNow MCP-server AI-agenten verbindt met beheerde ITSM-workflows, Action Fabric en veilige bedrijfsautomatisering, plus stappen voor 2026.
Read more →Incidentmanagement herstelt de dienstverlening; problem management zorgt dat hetzelfde incident niet terugkomt. De ITIL v4-gecertificeerde consultants van SMC Consulting richten problem management (ITIL) in HaloITSM in: terugkerende incidenten gegroepeerd in problemen, oorzaken onderzocht met een methode, known errors en workarounds gepubliceerd voor agents, en definitieve oplossingen aangevraagd als changes.



Problem management is de ITIL 4-practice die de kans op en de impact van incidenten verkleint door hun oorzaken te vinden, workarounds en known errors te beheren, en de oorzaken te laten wegnemen. Het doel: minder terugkerende incidenten, en kortere onderbrekingen wanneer ze toch gebeuren.
Het werkt op twee manieren. Reactief probleembeheer vertrekt van incidenten die al gebeurd zijn, vaak een major incident of hetzelfde ticket dat tien keer terugkwam. Proactief probleembeheer bekijkt trends, events en zwakke signalen om een oorzaak weg te nemen voordat ze iemand hindert.
| Incident | Probleem | Known error | |
|---|---|---|---|
| Wat het is | Een ongeplande onderbreking of kwaliteitsdaling van een dienst | De oorzaak, of mogelijke oorzaak, van een of meer incidenten | Een geanalyseerd maar nog niet opgelost probleem, meestal met een gedocumenteerde workaround |
| Doel | De dienstverlening zo snel mogelijk herstellen | De oorzaak vinden en wegnemen | Agents helpen het volgende voorval snel op te lossen, tot de oplossing er is |
| Eigenaar | De servicedesk en de supportteams | Een problemmanager of probleemeigenaar | Problem management, gepubliceerd voor de servicedesk |
| Eindigt wanneer | De gebruiker weer kan werken | De oorzaak weggenomen is, meestal met een change | De definitieve oplossing in productie is |
De ITIL-practices en hoe ze samenhangen, staan in de ITIL-processen uitgelegd en in onze praktische gids over ITSM; voor de incidentkant, zie incident management volgens ITIL 4. HaloITSM is de tool die wij het vaakst aanraden om beide uit te voeren.
Bron: de ITIL 4-praktijk Problem Management, ITIL 4 van PeopleCert.
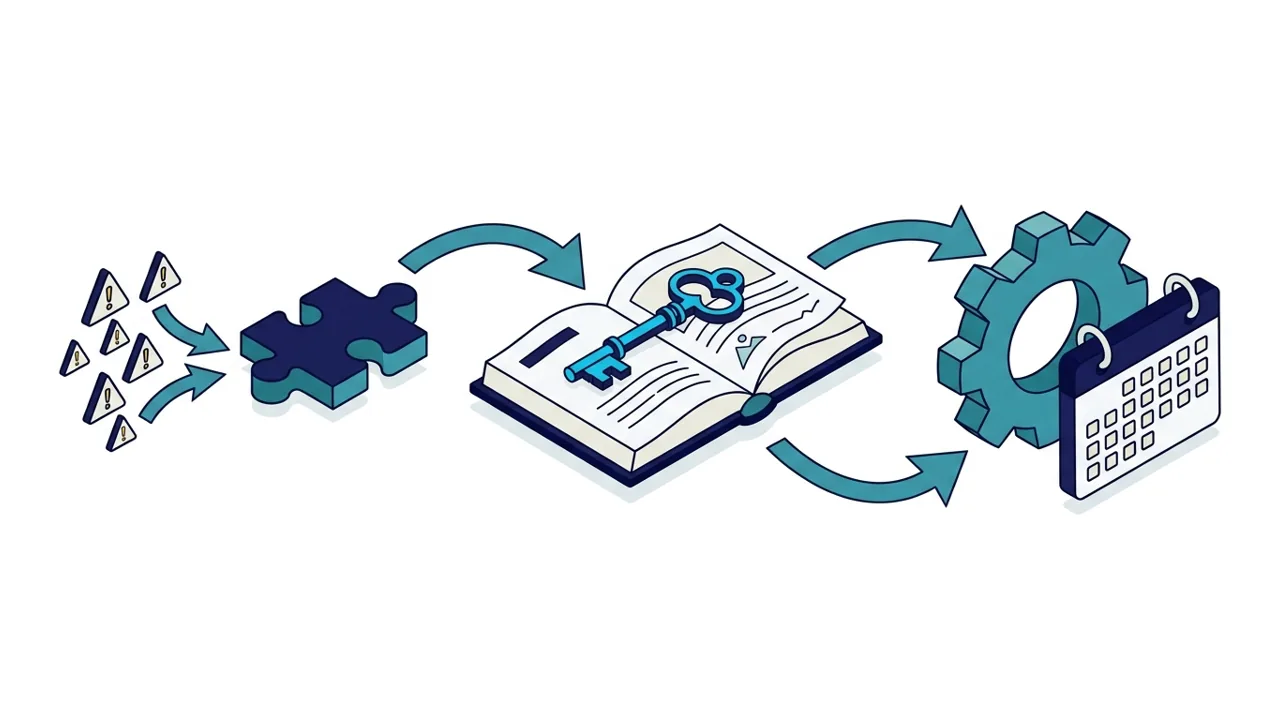
In HaloITSM koppelen agents gerelateerde incidenten en maken er een probleem van; trendrapporten tonen de terugkerende incidenten die niemand meldde.
De probleemrecord bevat het onderzoek: getroffen diensten en CI's, analyse, workaround en wie eraan werkt. Eenmaal geanalyseerd, wordt het probleem een known error.
Known errors worden beheerd: workarounds actueel gehouden, en de definitieve oplossing beoordeeld en als change aangevraagd wanneer dat verantwoord is.
Een maandelijkse blik op de grootste incidentcategorieën en diensten vindt problemen vóór het volgende major incident.
Een live demo op een van uw terugkerende incidenten, of een gratis proefperiode: 30 dagen, waarvan 15 begeleid door SMC Consulting.
De methode is minder belangrijk dan er één gebruiken. Wij voegen een oorzaaksectie toe aan het probleemformulier, zodat de analyse vastgelegd wordt en niet alleen besproken.
Vraag waarom tot u bij een oorzaak komt waarop u kunt handelen. Snel, goed voor de meeste problemen; vastgelegd als een korte keten op het probleem.
Oorzaken gegroepeerd per categorie (mensen, proces, technologie, leveranciers) wanneer meerdere factoren samenspelen; het diagram wordt aan het probleem toegevoegd.
Een gestructureerde vergelijking van wat wel en niet getroffen is, voor complexe technische problemen; de analysestappen worden taken op het probleem.
Elke known error legt de symptomen vast, de oorzaak wanneer die bekend is en de workaround die agents vandaag kunnen toepassen.
Known errors worden voorgesteld op overeenkomende incidenten, zodat het tweede voorval minuten duurt, geen uren.
Wanneer de workaround veilig is voor gebruikers, wordt hij een kennisartikel in het selfserviceportaal.
Vijf stappen, in België, Luxemburg en Frankrijk.
Weet u niet goed waar uw problem management vandaag staat? Boek uw gratis ITSM-audit: 30 minuten met een senior consultant. Kiest u nog een tool? Onze vergelijking van de 10 beste ITSM-tools zet HaloITSM naast de alternatieven.
Uw terugkerende incidenten, uw major incidents van de afgelopen maanden, en wie vandaag naar oorzaken kijkt.
Probleemstatussen, het probleemformulier met zijn oorzaaksectie, known-errorrecords en de koppelregels naar incidenten en changes.
Gebouwd in HaloITSM, met synchronisatie naar Jira of Azure DevOps voor development en Teams-meldingen.
Twee of drie echte problemen met uw team doorlopen, van identificatie tot de change.
Een maandelijkse trendreview opgezet, de KPI's hieronder op een dashboard, en een evaluatie na zes maanden.
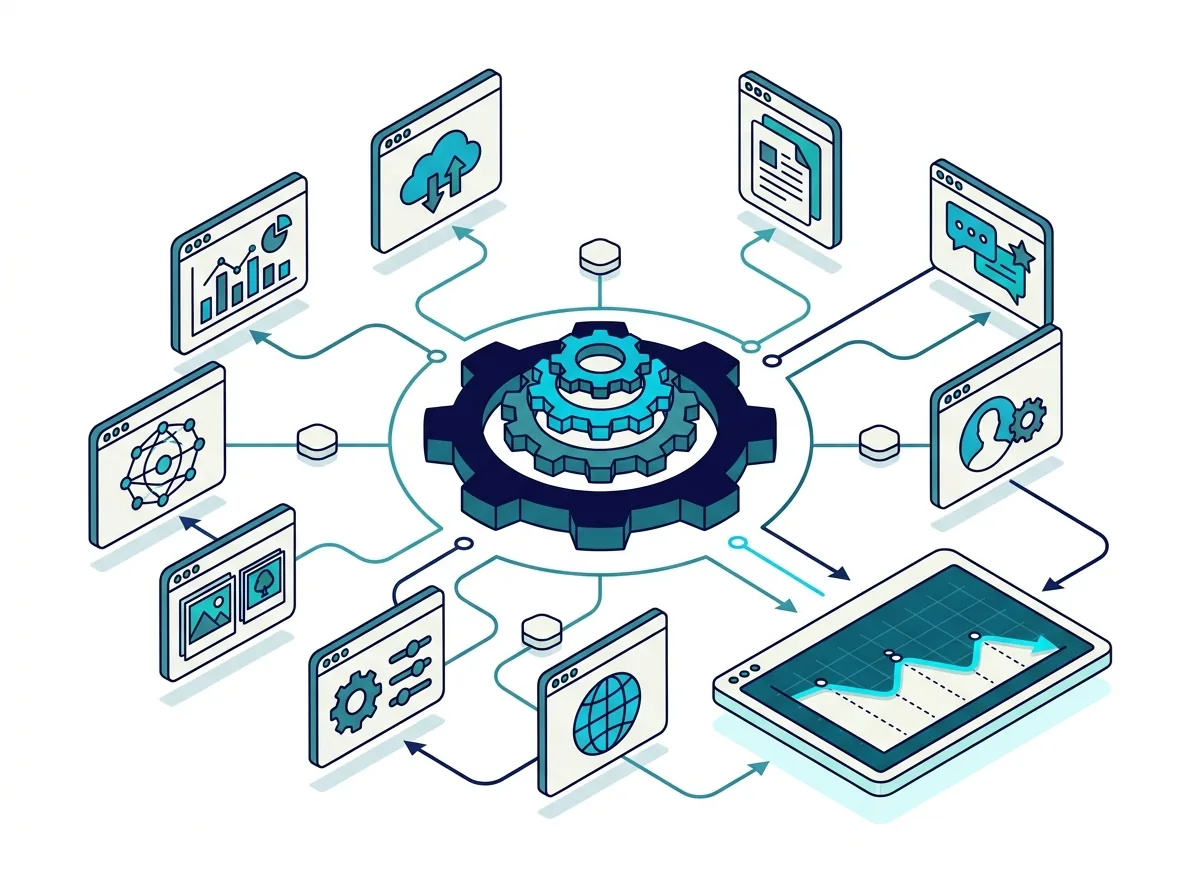
Incidenten worden aan het probleem gekoppeld en samen afgesloten zodra de oplossing er is.
De definitieve oplossing wordt vanuit het probleem als change aangevraagd, beoordeeld en goedgekeurd zoals elke andere.
Getroffen diensten en configuratie-items tonen welk deel van de omgeving telkens weer faalt.
Wier agents elke week hetzelfde incident oplossen zonder dat iemand de oorzaak wegneemt.
Die major incidents geanalyseerd en opgelost willen zien, niet alleen afgesloten.
Die geen problemmanager kunnen vrijmaken maar met de juiste tool wel een maandelijkse review kunnen houden.
Problem management is de ITIL 4-practice die de oorzaken van incidenten vindt en wegneemt. Ze beheert workarounds en known errors terwijl de definitieve oplossing wordt voorbereid, en werkt zowel reactief, vanuit incidenten, als proactief, vanuit trends.
De kans op en de impact van incidenten verkleinen: minder terugkerende incidenten, kortere onderbrekingen dankzij gekende workarounds, en definitieve oplossingen geleverd via change management.
Een incident is een onderbreking die nu hersteld moet worden; een probleem is de oorzaak achter een of meer incidenten. Het incident is afgesloten wanneer de gebruiker weer kan werken; het probleem blijft open tot de oorzaak weggenomen is. Zie incident management volgens ITIL 4.
De verzameling known errors: problemen die geanalyseerd maar nog niet opgelost zijn, met hun oorzaak wanneer bekend en hun workaround. In HaloITSM worden known errors voorgesteld op overeenkomende incidenten, zodat agents de workaround meteen toepassen terwijl de definitieve oplossing onderweg is.
Vaak de servicedeskverantwoordelijke of een infrastructuurengineer, enkele uren per maand. Wat telt: één benoemde eigenaar, een maandelijkse review van terugkerende incidenten, en een tool die de koppelingen tussen incidenten, problemen en changes bijhoudt.
Ja. Wanneer de oplossing ontwikkelwerk vraagt, worden probleemtaken gesynchroniseerd met Jira-issues of Azure DevOps-work items, zodat de status aan beide kanten gelijk blijft zonder manueel overtypen.
Boek een live demo op een van uw eigen terugkerende incidenten. U kunt ook een gratis proefperiode starten: 30 dagen, waarvan 15 begeleid door SMC Consulting.
Ontdek hoe de ServiceNow MCP-server AI-agenten verbindt met beheerde ITSM-workflows, Action Fabric en veilige bedrijfsautomatisering, plus stappen voor 2026.
Read more →
Ontdek hoe een HaloITSM Lansweeper-integratie discovery-data koppelt aan HaloITSM voor zuiverdere CMDB-records, snellere triage en betere change-beslissingen.
Read more →
Een praktisch ServiceNow migratie cutover-plan helpt risico's te beperken, de servicecontinuïteit te beschermen en een zelfverzekerde ITSM-modernisering te ondersteunen.
Read more →