
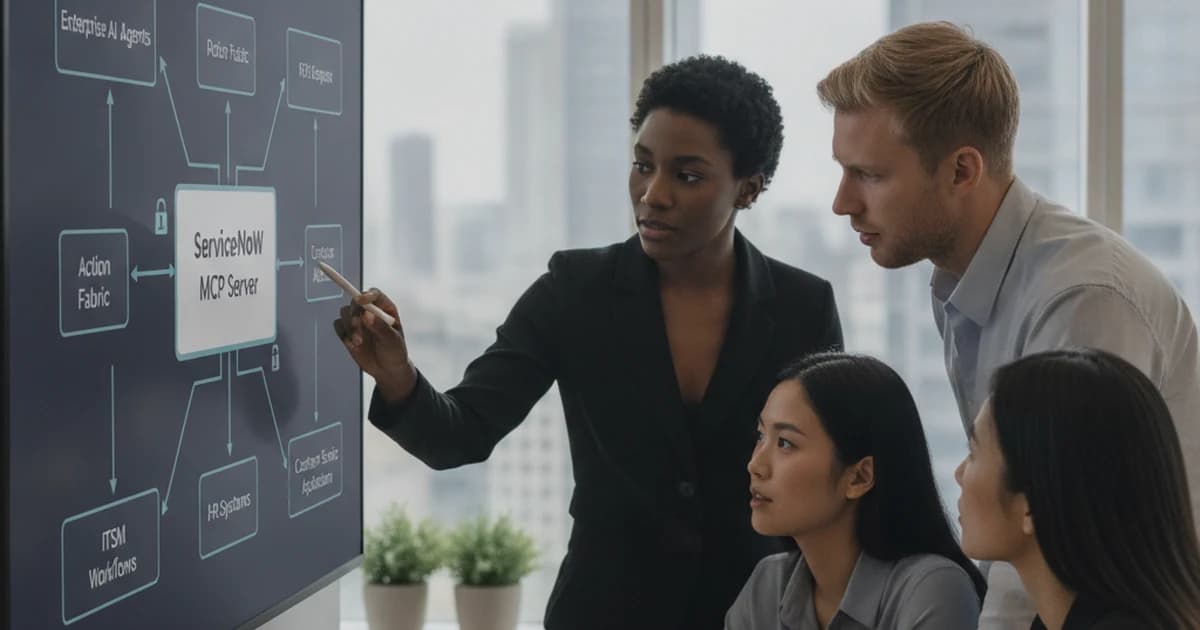
ServiceNow : Action Fabric et le serveur MCP expliqués pour l’ITSM
Le serveur MCP de ServiceNow connecte les agents IA aux workflows ITSM gouvernés et à Action Fabric pour une automatisation sécurisée. Préparez-vous pour 2026.
Read more →La gestion des incidents rétablit le service ; la gestion des problèmes ITIL fait en sorte que le même incident ne revienne plus. Les consultants certifiés ITIL v4 de SMC Consulting mettent en place la gestion des problèmes dans HaloITSM : incidents récurrents regroupés en problèmes, analyse des causes profondes avec une méthode, erreurs connues et contournements publiés pour les agents, et corrections définitives lancées comme changements.



La gestion des problèmes est la pratique ITIL 4 qui réduit la probabilité et l'impact des incidents en trouvant leurs causes, en gérant contournements et erreurs connues, et en faisant supprimer les causes. Son objectif : moins d'incidents répétés, et des interruptions plus courtes quand ils surviennent.
Elle fonctionne de deux façons. La gestion des problèmes réactive part d'incidents déjà survenus, souvent un incident majeur ou le même ticket vu dix fois. La gestion des problèmes proactive analyse tendances, événements et signaux faibles pour supprimer une cause avant qu'elle ne gêne quelqu'un.
| Incident | Problème | Erreur connue | |
|---|---|---|---|
| Ce que c'est | Une interruption imprévue ou une baisse de qualité d'un service | La cause, ou cause possible, d'un ou plusieurs incidents | Un problème analysé mais pas encore résolu, en général avec un contournement documenté |
| Objectif | Rétablir le service le plus vite possible | Trouver et supprimer la cause | Aider les agents à résoudre vite la prochaine occurrence, en attendant la correction |
| Responsable | Le centre de services et les équipes de support | Un gestionnaire ou responsable de problème | La gestion des problèmes, publiée pour le centre de services |
| Se termine quand | L'utilisateur peut de nouveau travailler | La cause est supprimée, en général par un changement | La correction définitive est en place |
Les pratiques ITIL et leurs liens sont expliqués dans les processus ITIL expliqués et dans notre guide pratique de l'ITSM ; pour le côté incident, voir la gestion des incidents selon ITIL 4. HaloITSM est l'outil que nous recommandons le plus souvent pour porter les deux.
Source : la pratique Problem Management (gestion des problèmes) d'ITIL 4, ITIL 4 publié par PeopleCert.
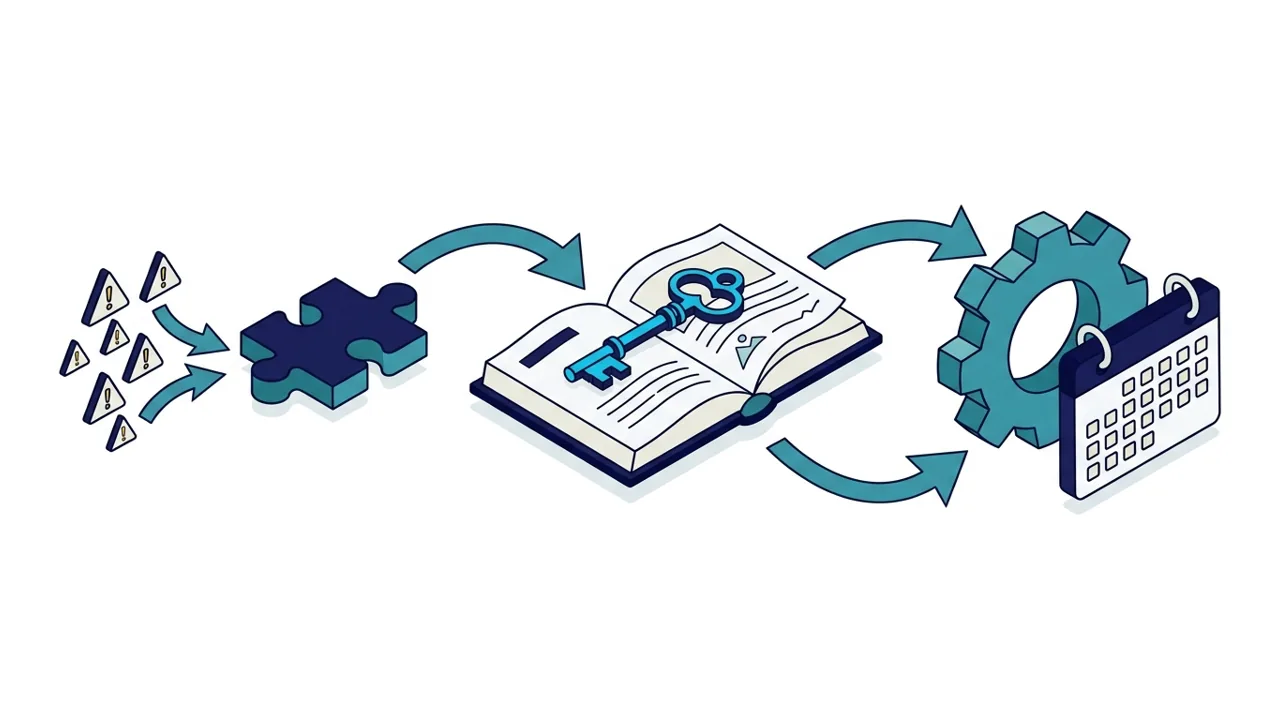
Dans HaloITSM, les agents relient les incidents liés et en créent un problème ; les rapports de tendance montrent les incidents répétés que personne n'a signalés.
La fiche problème porte l'investigation : services et CI touchés, analyse, contournement et personnes impliquées. Une fois analysé, le problème devient une erreur connue.
Les erreurs connues sont gérées : contournements tenus à jour, et correction définitive évaluée puis lancée comme changement quand elle se justifie.
Un regard mensuel sur les principales catégories d'incidents et les services trouve les problèmes avant le prochain incident majeur.
Une démo en direct sur l'un de vos incidents récurrents, ou un essai gratuit : 30 jours, dont 15 accompagnés par SMC Consulting.
La méthode compte moins que le fait d'en utiliser une. Nous ajoutons une section « cause profonde » au formulaire de problème pour que l'analyse soit enregistrée, pas seulement discutée.
Demander pourquoi jusqu'à atteindre une cause sur laquelle agir. Rapide, adaptée à la plupart des problèmes ; enregistrée comme une courte chaîne sur le problème.
Les causes regroupées par catégorie (personnes, processus, technologie, fournisseurs) quand plusieurs facteurs se combinent ; le diagramme est joint au problème.
Une comparaison structurée de ce qui est touché et de ce qui ne l'est pas, pour les problèmes techniques complexes ; les étapes deviennent des tâches du problème.
Chaque erreur connue enregistre les symptômes, la cause quand elle est connue et le contournement que les agents peuvent appliquer dès aujourd'hui.
Les erreurs connues sont suggérées sur les incidents correspondants : la deuxième occurrence prend des minutes, pas des heures.
Quand le contournement est sûr pour les utilisateurs, il devient un article de connaissance du portail self-service.
Cinq étapes, en Belgique, au Luxembourg et en France.
Vous ne savez pas où en est votre gestion des problèmes ? Réservez votre audit ITSM gratuit : 30 minutes avec un consultant senior. Vous choisissez encore un outil ? Notre comparatif des 10 meilleurs outils ITSM place HaloITSM face aux alternatives.
Vos incidents répétés, vos incidents majeurs des derniers mois, et qui analyse les causes aujourd'hui.
États des problèmes, formulaire de problème avec sa section « cause profonde », fiches d'erreurs connues et règles de liaison aux incidents et changements.
Construit dans HaloITSM, avec la synchronisation Jira ou Azure DevOps pour le développement et les notifications Teams.
Deux ou trois vrais problèmes menés avec votre équipe, de l'identification au changement.
Une revue mensuelle des tendances en place, les KPI ci-dessous dans un tableau de bord, et un bilan à six mois.
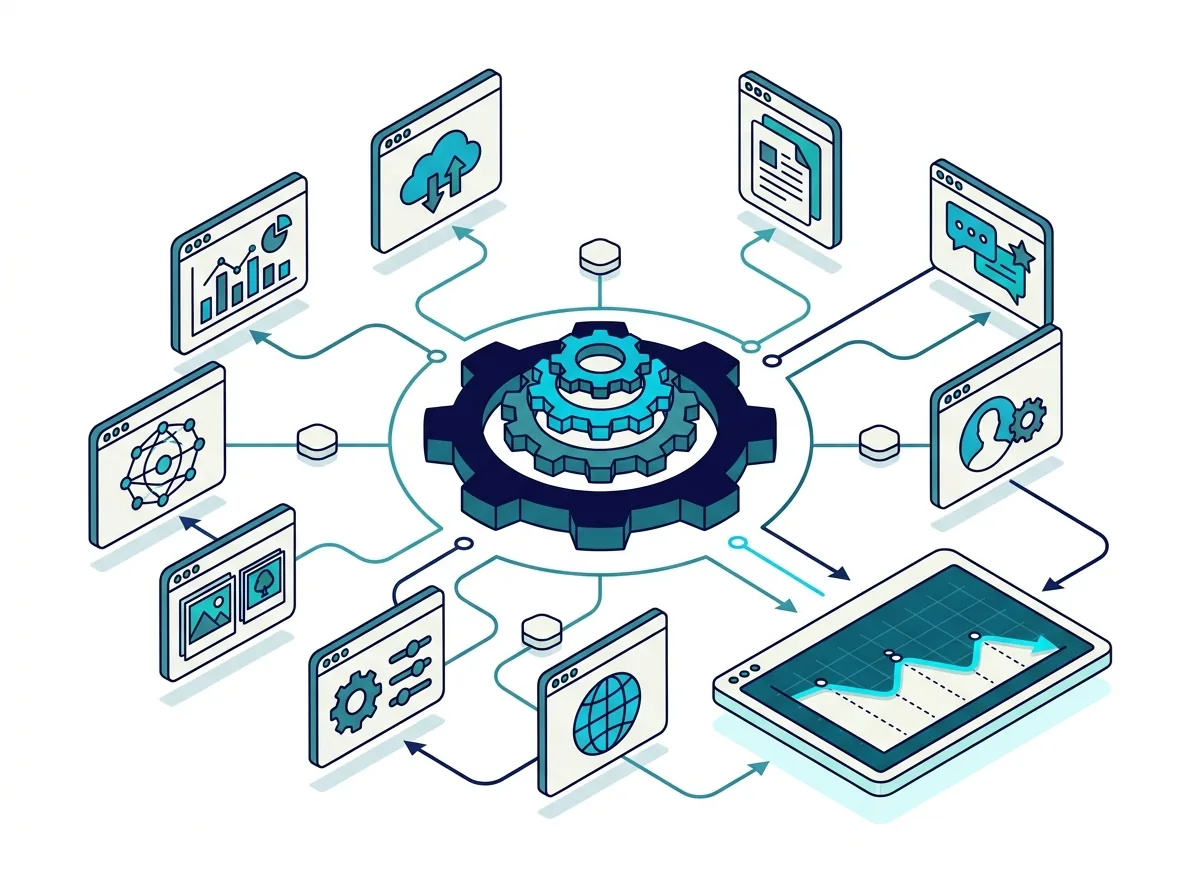
Les incidents sont liés au problème, et clôturés ensemble quand la correction est en place.
La correction définitive est lancée comme changement depuis le problème, évaluée et approuvée comme les autres.
Les services et éléments de configuration touchés montrent quelle partie du parc tombe en panne à répétition.
Dont les agents résolvent chaque semaine le même incident sans que personne n'en corrige la cause.
Qui ont besoin que les incidents majeurs soient analysés et corrigés, pas seulement clôturés.
Qui ne peuvent pas dédier un gestionnaire de problèmes mais peuvent tenir une revue mensuelle avec le bon outil.
La gestion des problèmes est la pratique ITIL 4 qui trouve et supprime les causes des incidents. Elle gère contournements et erreurs connues pendant la préparation de la correction définitive, et fonctionne de façon réactive, à partir des incidents, et proactive, à partir des tendances.
Réduire la probabilité et l'impact des incidents : moins d'incidents répétés, des interruptions plus courtes grâce aux contournements connus, et des corrections définitives livrées par la gestion des changements.
Un incident est une interruption à rétablir maintenant ; un problème est la cause d'un ou plusieurs incidents. L'incident est clos quand l'utilisateur peut travailler ; le problème reste ouvert jusqu'à la suppression de sa cause. Voir la gestion des incidents selon ITIL 4.
L'ensemble des erreurs connues : les problèmes analysés mais pas encore résolus, avec leur cause quand elle est connue et leur contournement. Dans HaloITSM, les erreurs connues sont suggérées sur les incidents correspondants : les agents appliquent le contournement tout de suite, en attendant la correction définitive.
Souvent le responsable du centre de services ou un ingénieur infrastructure, quelques heures par mois. L'essentiel : un responsable nommé, une revue mensuelle des incidents répétés, et un outil qui garde les liens entre incidents, problèmes et changements.
Oui. Quand la correction demande du développement, les tâches de problème sont synchronisées avec les tickets Jira ou les éléments de travail Azure DevOps : le statut reste identique des deux côtés sans recopie manuelle.
Réservez une démo en direct sur l'un de vos propres incidents récurrents. Vous pouvez aussi démarrer un essai gratuit : 30 jours, dont 15 accompagnés par SMC Consulting.
Le serveur MCP de ServiceNow connecte les agents IA aux workflows ITSM gouvernés et à Action Fabric pour une automatisation sécurisée. Préparez-vous pour 2026.
Read more →
Découvrez comment une intégration HaloITSM Lansweeper connecte les données de découverte à HaloITSM, pour des enregistrements CMDB plus propres, un tri plus rapide et de meilleures décisions de changement.
Read more →
Un plan de basculement pratique pour la migration ServiceNow réduit les risques, protège la continuité du service et soutient une modernisation ITSM sereine.
Read more →