SMC Consulting
Pratique ITIL 4 · Gestion des incidents

Gestion des incidents : le processus ITIL 4 qui rétablit le service vite

La gestion des incidents rétablit le service normal le plus vite possible quand quelque chose tombe en panne, et tient les utilisateurs informés pendant ce temps. Cette page explique le processus de gestion des incidents ITIL 4, la matrice de priorité, les SLA et les KPI, et comment SMC Consulting le paramètre dans HaloITSM ou dans l'outil que vous utilisez déjà.

180implémentations ITSM
40+migrations ITSM
20ans en gestion des services IT
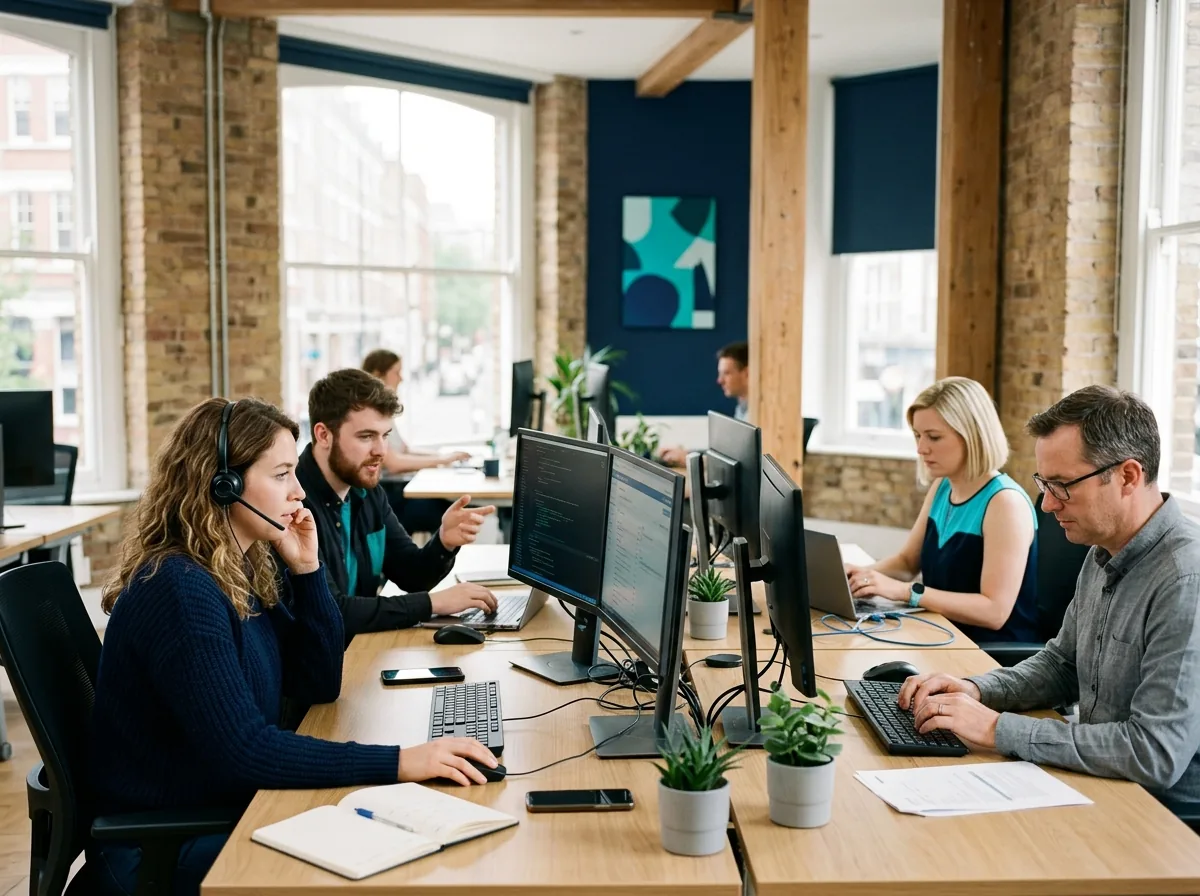
Gestion des incidents au service desk : agents avec casque traitant des tickets d'incident à leur poste
SMC Consulting

Ils nous font confiance sur leurs projets ITSM

  • Proximus
  • Lineas
  • Brussels Airport
  • ING
  • CPH Banque
  • DKV
  • Loterie Nationale
  • Crelan
  • Belfius
  • ALD Automotive
  • BNP Paribas Fortis
  • AXA
  • KBC

Qu'est-ce que la gestion des incidents en ITSM ?

La gestion des incidents est la pratique ITIL 4 qui réduit l'impact négatif des incidents en rétablissant le fonctionnement normal du service le plus rapidement possible. Un incident est une interruption imprévue d'un service, ou une baisse de sa qualité : le VPN refuse les connexions, une application est lente, les imprimantes d'un étage ne répondent plus. L'objectif est de remettre les utilisateurs au travail, pas encore de comprendre pourquoi c'est arrivé.

C'est ce dernier point qui distingue les incidents des pratiques voisines :

Ce que c'estObjectif
IncidentUne interruption ou dégradation imprévue d'un serviceRétablir le service vite
ProblèmeLa cause sous-jacente d'un ou plusieurs incidentsTrouver et supprimer la cause racine
Demande de serviceUne demande planifiée : accès, matériel, informationLa traiter via le catalogue
Incident majeurUn incident à fort impact métierRétablir le service avec une procédure dédiée

Mélanger incidents et demandes dans une même file ralentit les deux ; voir la gestion des demandes pour le volet demandes. La gestion des incidents est l'un des processus ITSM essentiels.

Relu par les consultants certifiés ITIL v4 de SMC Consulting. Source : la pratique Incident Management d'ITIL 4, ITIL 4 (PeopleCert).

Le processus de gestion des incidents, étape par étape

Six étapes, du premier signal au dossier clôturé. Chacune est paramétrée dans l'outil selon votre modèle opérationnel, pas laissée en configuration par défaut.

Quand la correction exige une modification en production, elle sort de la gestion des incidents et suit la gestion des changements.

  1. Détecter et enregistrer

    L'incident arrive par le portail, l'e-mail, Teams, un appel ou une alerte de supervision, et il est enregistré avec sa source, l'heure et les champs standard.

  2. Catégoriser et prioriser

    La catégorie suit votre catalogue de services ; la priorité découle de la matrice impact × urgence et fixe les objectifs SLA.

  3. Diagnostiquer et affecter

    Le niveau 1 consulte la base de connaissances et les erreurs connues, résout ce qu'il peut et affecte le reste au bon groupe de résolution.

  4. Analyser et escalader

    Les spécialistes analysent avec la CMDB et l'historique des incidents ; l'escalade se déclenche avant le dépassement du SLA.

  5. Résoudre et rétablir

    La correction ou le contournement est appliqué, l'utilisateur confirme le retour du service, et le code et les notes de résolution sont enregistrés.

  6. Clôturer et revoir

    Le dossier est clôturé avec des données propres ; les incidents récurrents et majeurs passent à la gestion des problèmes et alimentent la revue suivante.

Matrice de priorité, SLA et escalade

La priorité n'est pas une impression. Elle découle de deux questions : combien de personnes ou quelle part de l'activité sont touchées (l'impact), et à quelle vitesse le dommage augmente (l'urgence). En les croisant, on obtient une priorité que chaque agent applique de la même façon.

Impact \ UrgenceHauteMoyenneBasse
Haut (un service ou un site à l'arrêt)P1 CritiqueP2 HauteP3 Moyenne
Moyen (une équipe ou un département)P2 HauteP3 MoyenneP4 Basse
Faible (un utilisateur, un contournement existe)P3 MoyenneP4 BasseP5 Planifiée

Chaque priorité porte ensuite un objectif de prise en charge et de résolution. Les valeurs dépendent de vos services, de vos horaires et de vos contrats : nous les fixons avec vous au lieu de recopier un modèle. Deux règles les rendent efficaces : le chronomètre SLA démarre à l'enregistrement de l'incident, et l'escalade se déclenche avant le dépassement (par exemple à 75 % du temps écoulé), quand il est encore temps d'agir. L'escalade fonctionnelle transfère le ticket à une équipe plus spécialisée ; l'escalade hiérarchique prévient un responsable quand une décision ou des moyens supplémentaires sont nécessaires.

Incidents majeurs et lien avec les problèmes et les changements

Une procédure dédiée aux incidents majeurs

Des critères clairs pour déclarer un incident majeur, un responsable désigné, une équipe dédiée et un circuit de décision raccourci. Mieux vaut déclarer tôt qu'escalader tard.

Une communication à rythme fixe

Utilisateurs et direction reçoivent des points d'étape à intervalles convenus, via le portail, Teams ou l'e-mail, pour que le service desk ne croule pas sous les « du nouveau ? ».

Passage de relais à la gestion des problèmes

Une fois le service rétabli, les incidents récurrents ou majeurs deviennent des problèmes : cause racine, erreur connue, contournement, correction définitive.

Gestion des problèmes

Des corrections qui passent par le changement

La correction définitive est un changement : évalué, approuvé et planifié, pour que le remède ne cause pas le prochain incident.

Gestion des changements

La gestion des incidents dans HaloITSM : comment nous la paramétrons

Nous travaillons en quatre phases : concevoir le modèle opérationnel, paramétrer l'outil, ajouter connaissance, IA et automatisation, puis former et transférer. HaloITSM est notre choix pour la plupart des organisations de taille moyenne, mais le processus fonctionne sur chacune des 10 plateformes ITSM où nous intervenons : nous paramétrons le même modèle dans l'outil que vous avez déjà.

Saisie sur tous les canaux

E-mail, portail libre-service, Microsoft Teams, API et alertes de supervision, avec des formulaires standard et des champs obligatoires pour un premier enregistrement exploitable.

Règles de tri et de routage

Des catégories alignées sur vos services, et un routage par catégorie, service touché et utilisateur, pour que le ticket arrive du premier coup au bon groupe de résolution.

Chronomètres SLA et escalade

Des objectifs de prise en charge et de résolution par priorité, des alertes avant le dépassement et des chemins d'escalade convenus avec chaque équipe.

La connaissance au bon moment

Des articles pertinents suggérés aux agents pendant l'analyse et aux utilisateurs à la saisie, et une invitation à mettre la base à jour à la clôture.

Gestion des connaissances

Impact via la CMDB

Des incidents liés aux éléments de configuration et aux services, pour que les agents voient ce qui est touché et que la gestion des problèmes repère les tendances.

CMDB HaloITSM

Teams et intégrations

Création de tickets, suivi et approbations dans Teams, et liens avec Jira, Azure DevOps et PagerDuty quand des équipes de développement ou d'astreinte sont impliquées.

Répondre aux appels d'incident avec un helpdesk IA

Beaucoup d'incidents arrivent encore par téléphone, souvent hors des heures de bureau. AurionAI, un helpdesk IA pour le support IT édité par notre partenaire AurionAI SRL, répond 24/7 aux appels, chats et e-mails, vérifie l'appelant, et résout la demande ou crée le ticket d'incident dans votre ITSM avec sa catégorie et sa priorité. Les agents partent d'un ticket complet plutôt que d'un message vocal.

Backlog qui grossit ou SLA dépassés chaque mois ?

Lors d'un audit gratuit de 30 minutes, un consultant senior passe en revue avec vous votre processus d'incidents, vos priorités et vos SLA, et vous repartez avec vos trois priorités.

Ce qu'un processus d'incidents bien mené vous apporte

  • Un modèle de priorité que chaque agent applique de la même façon
  • Des dépassements de SLA anticipés au lieu d'être justifiés après coup
  • Moins de tickets qui rebondissent entre groupes de résolution
  • Des utilisateurs informés sans devoir relancer le service desk
  • Des incidents récurrents confiés à la gestion des problèmes au lieu d'être corrigés encore et encore
  • Des rapports que votre direction lit, construits sur des données de clôture propres

Pratiques et outils liés

Optimisation du service desk

Quand le backlog ne cesse de grossir, la solution se trouve en général dans le tri, la conception des SLA et la connaissance, pas dans un nouvel outil.

Optimisation du service desk

Une demande n'est pas un incident

Les demandes d'accès, de matériel et d'information ont leur place dans le catalogue de services, avec leurs propres formulaires et approbations.

Gestion des demandes

Pour qui

Responsables du service desk

Qui portent la file, les SLA et les escalades au quotidien et ont besoin d'un processus que toute l'équipe applique.

DSI et responsables IT

Qui veulent moins d'interruptions, un rétablissement plus rapide et des chiffres à présenter aux métiers.

Responsables des incidents et des problèmes

Qui veulent un cycle de vie, des priorités et des passages de relais que les équipes suivent vraiment.

Les KPI de gestion des incidents à suivre

KPICe qu'il vous dit
Délai moyen de résolution (MTTR)Le temps moyen entre l'enregistrement et la résolution, par priorité.
Résolution au premier contact (FCR)La part d'incidents résolus au premier contact, sans escalade.
Respect des SLALa part d'incidents résolus dans les délais, et l'écart pour les autres.
Taux de réouvertureLes incidents rouverts après résolution : un signal direct de la qualité des corrections.
Âge du backlogDepuis combien de temps les incidents ouverts attendent ; les plus anciens montrent où le processus coince.

Définitions, formules et objectifs : voir notre guide des KPI ITSM.

Gestion des incidents : questions fréquentes

Quelle est la différence entre un incident et un problème ?

L'incident est l'interruption elle-même : un service est arrêté ou dégradé et les utilisateurs en ont besoin. Le problème est la cause derrière un ou plusieurs incidents. La gestion des incidents rétablit le service au plus vite ; la gestion des problèmes trouve et supprime la cause pour que l'incident ne revienne pas.

Quelles sont les étapes du processus de gestion des incidents ITIL ?

Détecter et enregistrer, catégoriser et prioriser, diagnostiquer et affecter, analyser et escalader, résoudre et rétablir, clôturer et revoir. ITIL 4 n'impose pas de séquence figée, mais ces six étapes sont celles que suivent la plupart des service desks, et chacune doit être visible dans l'outil.

Comment prioriser les incidents ?

Avec une matrice impact × urgence. L'impact mesure la part de l'activité touchée, l'urgence la vitesse à laquelle le dommage augmente ; leur combinaison donne une priorité de P1 à P5, et chaque priorité porte ses propres objectifs SLA. La matrice doit être assez simple pour que tous les agents arrivent à la même réponse.

Quels KPI mesurent la gestion des incidents ?

Le délai moyen de résolution, la résolution au premier contact, le respect des SLA, le taux de réouverture et l'âge du backlog, complétés par la satisfaction des utilisateurs. Suivez une courte liste chaque mois et agissez dessus. Notre guide des KPI ITSM donne les définitions.

Qu'est-ce qu'un incident majeur ?

Un incident dont l'impact métier est assez élevé pour justifier sa propre procédure : un responsable d'incident majeur désigné, une équipe dédiée, une communication régulière vers les utilisateurs et la direction, et une revue après coup. Les critères de déclaration se fixent à l'avance, pas pendant la panne.

Faut-il HaloITSM pour améliorer la gestion des incidents ?

Non. Le processus, la matrice de priorité et les SLA viennent d'abord, et ils fonctionnent dans n'importe quel outil ITSM. HaloITSM est notre choix quand un changement d'outil est envisagé ; sinon, nous paramétrons votre plateforme actuelle. Un audit gratuit de 30 minutes vous dit ce qui s'applique.

Rétablissez le service plus vite, avec un processus que votre équipe applique

Réservez votre audit ITSM gratuit de 30 minutes. Un consultant senior passe en revue votre processus d'incidents, vos priorités et vos SLA, et vous repartez avec vos trois priorités.